担当フリーランスがいなくなったシステム、弊社が引き取ります
背景
2010年代後半から、働き方改革の流れとクラウドソーシングサービスの普及を背景に、フリーランスエンジニアが急増しました。時間や場所にとらわれない柔軟な働き方、高単価案件への直接参加、副業解禁の波も追い風となり、多くのエンジニアが会社員からフリーランスへと転身しました。
しかし近年、その流れに変化が生じています。
リクルートエージェントの調査によると、2024年4月〜9月にフリーランスから正社員へ転職した人数は5年前の2.8倍に達したとのこと。収入の不安定さやAIの台頭による将来への不安、社会保険・福利厚生の手厚さへの再評価など、正社員に戻る理由はさまざまです。
このとき見落とされがちな問題があります。フリーランスが担当していたシステムの引き継ぎ先です。
これまでフリーランスのプログラマーが開発保守を担当していた各種システム。そのプログラマーが廃業した後は、誰が保守を担っていくのでしょうか?
弊社では、そんな企業様のためのサービスを、この度リリースしました。
DevEdge Fosterとは?
https://studioplustwo.jp/service/fosterstudioplustwo.jp
DevEdge Foster(デヴエッジ・フォスター)は、引き取り手がいなくなったプログラムやシステムを引き継ぎ、継続的に運用していく、開発・保守サービスです。
- システム保守管理に豊富な経験を持つエンジニアが、責任をもって継続開発、保守運用を実施します。
- 初回の相談、調査、現状レポートの作成無料。リスクおよび費用を確認した上で、サービスの導入可否をご判断いただけます。
- PHP、Rubyをはじめとした、さまざまなプログラミング言語に対応しています。
- 引き継ぎ資料がなくても、ソースコードが複雑でも引き取ります。ご相談ください。
対象ユーザー
こんな内容でお困りの方におすすめです
- 担当していたフリーランスが突然連絡を絶ってしまった
- フリーランスが転職・廃業し、システムの引き継ぎが宙に浮いている
- 動いてはいるが、誰も中身を理解していないシステムがある
- 修正・改善したいが、どこに頼めばいいかわからない
事例
弊社では、さまざまな引き継ぎ案件を対応してきた実績があります。以下はその一例です。
- レガシーPHPで実装された不動産物件管理システムを、そのままの形で引き取って、保守管理
- 独自フレームワークで実装されたECサイトを、EC-CUBEに移植した上で保守管理
- CakePHPで実装された社内向けシステムを引き継ぎ、継続的に機能開発を実施
よくある質問
Q. 引き継ぎ資料がない場合でも対応できますか?
はい、対応可能です。ソースコードのみでも引き取ります。まずはご相談ください。
Q. 対応できない言語・フレームワークはありますか?
PHP・Ruby(Rails)を中心に幅広い言語・フレームワークに対応しています。まずはご相談ください。
Q. 費用の目安を教えてください。
初回の調査・現状レポート作成は無料です。その後の保守・運用費用はシステムの規模・状態によって異なりますので、現状レポートをご確認いただいた上でお見積もりします。青天井になることはありません。
Q. どのくらいの期間で引き取りが完了しますか?
システムの規模・状態によりますが、初回調査・レポート提出まで概ね1〜2週間を目安にしています。その後の保守開始までのスケジュールはご相談の上で決定します。
おわりに
システムの引き継ぎ先でお困りの方は、弊社問い合わせフォームからお問い合わせください。初回相談およびレポート作成は無料です!
1つのCloudflareアカウントに複数のGitHubアカウントを連携することは(たぶん)できない
株式会社スタジオプラスツーの佐藤です。
この記事でわかること
- 1つのCloudflareアカウントに複数のGitHubアカウントを連携することは(たぶん)できない(2026年5月現在)
以下本文
弊社では、技術検証によくCloudflare Pagesを使用しています。その中で、私の個人GitHubアカウントにある一つのリポジトリを、弊社のCloudflareアカウントと連携したいと考えました。
Cloudflare Pagesの管理画面から、GitHubアカウントの連携を追加したのですが...。
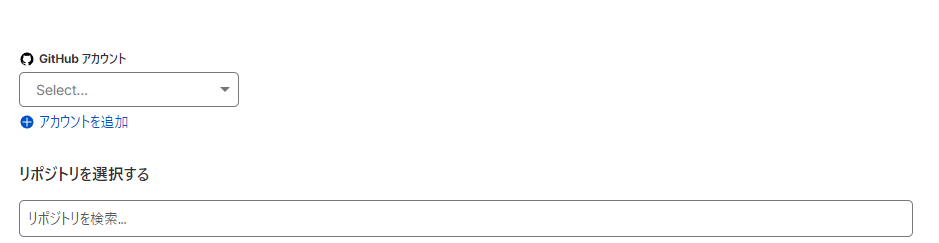
あれ?私のGitHubアカウントが選択肢に出てこない?
一覧にはリポジトリが表示されているので、選択して「セットアップの開始」をクリックしてみましたが、何も起きません。
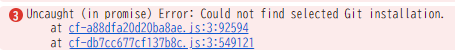
不思議に思ってブラウザのコンソールを確認したところ、"Could not find selected Git installation." というエラーが表示されていました。
不具合かと思い調べてみたところ、2024年と少し古いのですが、以下のような情報が見つかりました。
At this time, Cloudflare Pages and GitHub connections are a 1:1 relationship. Unfortunately, this means you can not cross-connect accounts between Cloudflare and GitHub. A Cloudflare account can not link to two GitHub accounts at the same time, and a GitHub account can not link to two Cloudflare accounts at the same time.
いまのところ、Cloudflare PagesとGitHubの接続は1対1の関係です。残念ながらCloudflareとGitHub間でアカウントを相互に接続はできません。1つのCloudflareアカウントを2つのGitHubアカウントに同時にリンクすることはできず、1つのGitHubアカウントを2つのCloudflareアカウントに同時にリンクすることもできません。
もともと弊社のCloudflareアカウントには、弊社のGitHub organizationアカウントを連携させていまして、そこに私個人のGitHubアカウントを追加で連携しようとしたときに、今回のエラーが発生しています。
なので、おそらく今遭遇している現象は、上記のリンクの現象とほぼ同じとみてよさそう。
これ以上調査する時間がないため、今回は「1つのCloudflareアカウントに複数のGitHubアカウントを連携することはできない」と結論づけました。
幸い今回は検証用のリポジトリだったため、個人アカウントからorganizationにリポジトリをそのまま移行すれば済む話ではあります。 しかし、Cloudflare Pagesの管理画面は、複数のGitHubアカウントに対応しているかのようなUIのままになっているので、少々モヤっとしますね。
おわりに
今回のような技術的なハマりどころの調査・検証も含め、株式会社スタジオプラスツーではWebシステムの設計・開発を幅広く承っています。お困りの際はぜひとも弊社までお声がけください。
ソフトウェア開発の工数見積もりの考え方

ソフトウェア開発の工数見積もりは、多くの現場で悩まれるテーマです。
当然ながら、あくまで未来の作業量を予測するものなので、厳密な正解は存在しません。
しかし、だからこそ「どのように考え、どの視点で見積もるか」に、その人の技術観・経験・姿勢が表れます。
この記事では、弊社が普段どのように工数見積もりを構築しているかを、できる限り丁寧に言語化しました。
特に業務系アプリケーションの開発を行うエンジニアやプロジェクト担当者の方にとって、参考になる部分があれば幸いです。
全体像を立体的に描く

見積もりの第一歩は、顧客からのヒアリング内容をもとに、「プロダクト全体の構造を頭の中で立体的に組み立てること」から始まります。
たとえば業務系アプリの場合、データ構造と画面の種類は強く連動しています。
ひとつのマスターテーブルを扱う機能であれば、次のような画面が自然と必要になります。
- 一覧画面
- 新規作成画面
- 編集画面
- etc...
このように、データ構造をざっくりイメージすると、必要な画面群が自然と浮かんできます。
また、どのアプリでも避けて通れない共通機能があります。例に挙げると以下のようなものです。
- ログイン / ログアウト
- ロールや権限設定
- ログインユーザ管理
- パスワード変更
これらの機能は、個別機能に依らず必要される場合がほとんどなので、特別な要件がある場合を除いて最初から見積もりに組み込みます。
なお、機能を分割する際は、顧客側が理解しやすいよう、「画面単位」ではなく「画面のまとまりをひとつの機能」として扱うようにしています。
たとえば「商品管理機能」というような形で、一覧・登録・編集・検索などの小機能をひとまとまりとして扱うことで、イメージがしやすくなります。
画面を持たない処理(バッチ・バックグラウンド処理等)については、トリガーや処理内容を基準に“まとまり単位”で切り出し、機能として見積もります。
このように「実装するシステムの具体的なイメージを立体的に組み立てながら見積もりを検討する」ことが基本となります。
過去の経験からスケール感を推定する
工数を検討するにあたっては、「過去の似たような案件」と照らし合わせて、以下のような考察を実施します。
- 過去案件に、今回要求されているものと類似のものが存在するか
- 存在する場合、画面数や処理数はどのくらいか
- その時と比べて、設計や実装の複雑度は高いか低いか
- 外部連携はあるか
完全に同じ案件はありませんが、「似ている点」と「異なる点」を比較することで、規模感が掴めるようになります。
ただし注意が必要なのは、過去の案件の工数をそのまま横展開しないことです。
たとえば、機能の実現に使用するプロダクトAで実現できた機能が、プロダクトBでは単純に実現することができず、工数が大きく変わる可能性があります。
曖昧さを分割して理解する

見積もりを進めていると、「ここだけはどうしてもイメージできない」という部分が生じることがあります。
この曖昧さを放置すると、後半で大きな手戻りに発展するため、イメージできない部分は、まずその背景を丁寧に切り分けるようにしています。
理由として多いのは次のようなものです。
- 実装方式がわからない
- 顧客の説明が抽象的すぎる(背景・目的が曖昧)
- 作るべきものの仕様が明確でない
- 外部連携先(APIなど)の仕様が不明
- 制約的に実現可能か疑わしい
理由の切り分けができると、
- 調査すべき領域
- 再ヒアリングすべき箇所
- リスクとして扱うべき点
がより明確になります。
事前調査の見切り所を知る
事前調査においては、利用するプロダクトの公式ドキュメントなど、正確性の高い情報ソースを参考にします。
ネット上の情報(ブログ記事、Qiita、Stack Overflow など)についても、必要に応じて参考にしますが、情報の正確性には十分注意します。
これらの情報は不正確なことも多いため、正確性は十分に確認する必要があります。
小さく確認できそうな場合は、簡単な実装のプロトタイプを作ることもあります。
ただし、所要時間に対して見積もりの精度が上がらないことも想定されるため、あくまで最小限の確認に留まる場合に限定しています。
これらの調査を進めても不確実性が解消されない場合は、事前検証フェーズなどの、実装前にリスクポイントを明らかにする工程を追加するなどの工夫が必要となります。
コミュニケーション起因の不確実性を見抜く

工数は技術だけで決まるものではありません。顧客側の説明の精度・コミュニケーションの特性・要件の固まり具合も工数に大きく影響します。
例えば次のような場合、不確実性が高いと判断できるかと思います。
- 願望レベルのざっくりとした要望しか出てこない
- 説明が毎回少しずつ変わる
- 極端な短納期・低予算を求められる
- 言葉遣いや前提条件が曖昧
これは単なる「嫌な予感」ではなく、過去の経験から積み重なった「リスクのシグナル」です。
こうした兆候がある場合には、仕様調整やコミュニケーションにかかる時間を見越して、見積もり工数にある程度のバッファを上乗せするのが安全です。
避けるべきアンチパターン

実務の中で、特に避けるべきだと感じている見積もりのアンチパターンがあります。
バッファを設けない
最善のケースのみを想定した見積もりではなく、潜在的なリスクについて常に意識をしておく。
過去案件の工数をそのまま横展開
技術的背景が違えば工数も変わるため、安易な横展開は避ける。
機能の粒度が大きすぎる
「管理機能まとめて30人日」のように、 ひとつの機能の粒度が大きすぎる場合、大機能を分割して複数の小機能と扱ったほうが、精度面および管理面に優れる。
前提条件を明示しない
前提条件は、正確な見積もりのベースとなる重要事項のため、見積もりの提示に際しては決して曖昧にしない。
まとめ

より正確な見積もりを作成するためには、以下のものが必要になると考えています。
- 要件から構造を描く力
- 過去の案件のスケール感を参照する力
- わからない理由を切り分ける力
- 必要な深さで調査する力
- 顧客の言動から不確実性を察知する力
- 危険な見積もりパターンを避ける判断力
この記事で触れた、見積もりや技術判断の考え方は、日々の開発プロジェクトでも役に立つものばかりです。
弊社では、企業の技術的な意思決定やプロジェクト運営を継続的に支援する「レンタルCTOサービス」を提供しています。
「技術の相談役がいつでもそばにいる状態」をつくりたい企業担当者の方がいらっしゃれば、ぜひ一度サービス内容をご覧ください。
Rubyでワンライナーを書く上で必要となる主なオプションの一覧
簡単な作業を実行したいときに、ワンライナーで手早く処理するケースはそれなりに多く、その際に手慣れた言語を使用できると非常に便利である。
ここでは、 Ruby でワンライナーを書くために最低限必要となるオプション一覧をメモしておく。
以下に挙げるオプションさえ覚えておけば、最低限困ることはないはず...?
-e オプション
引数にファイル名を取らずに、引数に与えられた文字列をそのまま Ruby スクリプトとして解釈して実行する。
$ ruby -e 'puts "ラーメン"'
ラーメン
-n オプション
標準入力として与えられた文字列の各行に対して Ruby スクリプトを実行する。各行の文字列は $_ 変数に格納される。
$ echo 'ラーメン\nそば\nうどん' | ruby -ne 'puts "カレー" + $_'
カレーラーメン
カレーそば
カレーうどん
-pオプション
スクリプト実行の最後に $_ の値をを標準出力に出力する。それ以外は -n と同じ。
$ echo 'ラーメン\nそば\nうどん' | ruby -pe '$_ = "カレー" + $_'
カレーラーメン
カレーそば
カレーうどん
-a オプション
-n や -p と一緒に用いた際に、各行の文字列が split されて $F 配列に格納される。
なお、split メソッドのデフォルトの挙動は「先頭と末尾の空白を除いたうえで、空白文字列で分割する」。
$ echo 'ラーメン そば うどん\nカレー 牛丼 かつ丼' | ruby -ane 'puts $F[1]'
そば
牛丼
-l オプション
行末の自動処理(読み込み時の改行除去、出力時に行末に自動で改行を付与)を行う。
$_変数の末尾に改行が残っていることにより、意図しない結果が出力される場合の回避策として使用できる。
$ echo 'ラーメン\nカレー\nうどん' | ruby -ne 'puts $_ + "野郎"'
ラーメン
野郎
カレー
野郎
うどん
野郎

(↑ 改行が末尾に付いているため、意図しない結果になる)

$ echo 'ラーメン\nカレー\nうどん' | ruby -nle 'puts $_ + "野郎"'
ラーメン野郎
カレー野郎
うどん野郎
-iオプション
-pや-nと併用することで、引数として指定されたファイルの内容を置換する。
-i.bak のように拡張子を指定すると、バックアップファイルとして指定拡張子が付いたファイルを作成する。
リポジトリ内の全てのソースコードの変数名を一括置換したり等、活用の場はそれなりに広い。
$ ruby -i.bak -pe '$_.upcase!' hoge.txt
(hoge.txt の中身の英文字を、全て大文字に置換し上書き。hoge.txt.bak というバックアップファイルを作成する。)
Ubuntu + PostgreSQL + PGroonga 環境における、PostgreSQL 14 へのアップグレード手順
当スタジオにて運用中のシステムで稼働している PostgreSQL 13 系 を 14 系 にアップグレードしたときの手順を紹介。
当該システムでは PGroonga による全文検索機能を実現しているのだが、PGroonga 2.3.2 により PostgreSQL 14 系がサポートされるようになったため、満を持してアップグレードを実施することに。
参考: https://pgroonga.github.io/ja/news/#version-2-3-2
はじめに注意点
PGroonga をアップグレード → その後に PostgreSQL をアップグレードという手順も試したものの、14系対応バージョンのPGroongaでも、13系のPostgreSQLライブラリでビルドした場合、13系用バージョンとなってしまい14への移行時に version mismatch エラーが発生する模様。
「PostgreSQL 14系のライブラリのみをまず入れる」→「14系用のPGroongaをビルド&インストール」→「PostgreSQL 14本体をインストール&13からのアップグレード」という、少々トリッキーな手順で実施すればうまくいく可能性もあるが、今回は PostgreSQL を先にアップグレードする手順を採用した。(後者の場合、インデックスの再構築は必要となる一方、手順に紛れがないので、インデックス再作成により停止時間が長くなるのを許容できるのであればおススメ)
アップグレード前の構成
- Ubuntu 20.04 LTS
- PostgreSQL 13.1
- PGroonga 2.2.6
PostgreSQL 14 のインストール
まずは作業前に、PostgreSQLのデータバックアップを実施。
Ubuntu では、pg_upgradecluster をはじめとした専用のコマンドが存在するため、今回はこれらを使用していく。
PostgreSQL の公式 apt リポジトリを追加していない場合は、以下の手順に従って追加作業を実施。
PostgreSQL 14のサーバ/クライアント/ビルド用ライブラリをインストール。
$ sudo apt install postgresql-14 postgresql-client-14 postgresql-server-dev-14
インストール後は、PostgreSQLがクラスタに自動追加されるため、 pg_dropcluster コマンドにより PostgresSQL 14を手動で削除。
$ pg_lsclusters
(...14系がインストールされていることを確認)
$ sudo pg_dropcluster 14 main --stop
さらに PostgreSQL サービスを停止した後、pg_upgradecluster コマンドにより13からのアップグレードを実施。
アップグレードにはデータサイズに応じた時間を要する。
$ sudo systemctl stop postgresql.service
$ sudo pg_upgradecluster 13 main
pg_upgradecluster でこんなエラーが出て、全文検索インデックスのみ移行がスキップされる形となるが、アップグレード自体は成功する。
ERROR:  incompatible library "/usr/lib/postgresql/14/lib/pgroonga.so": version mismatch
DETAIL:  Server is version 14, library is version 13.
ERROR:  extension "pgroonga" does not exist
ERROR:  access method "pgroonga" does not exist
アップグレード後は PostgreSQL を起動
$ sudo systemctl start postgresql.service
Groonga のアップグレード
Ubuntu 20.04 標準で利用できる Groonga だとバージョンが足りないため、まずはGroongaのアップグレードを実施。
参考 : https://groonga.org/ja/docs/install/debian.html
$ wget https://packages.groonga.org/debian/groonga-apt-source-latest-buster.deb
$ sudo apt install -y -V ./groonga-apt-source-latest-buster.deb
$ sudo apt update
$ sudo apt install libgroonga-dev
PGroonga のビルド
参考: https://pgroonga.github.io/ja/install/ubuntu.html
前述通り、2.3.2以降であれば PostgreSQL 14 に対応している。本記事を執筆時点の PGroonga 最新版は 2.3.4 なのでこちらを採用。
$ wget https://packages.groonga.org/source/pgroonga/pgroonga-2.3.4.tar.gz
$ tar xvfz pgroonga-2.3.4.tar.gz
$ cd pgroonga-2.3.4/
$ make HAVE_MSGPACK=1
PGroongaのアップグレード
システム側のプロセスを全停止し、PGroongaをインストール。
$ sudo make install
全文検索インデックスの再作成
管理ユーザで psql を起動し、psql上で以下のSQL文を実行し、pgroonga拡張を作成。
CREATE EXTENSION pgroonga;
さらに以下のSQLを実行し、全文検索インデックスを再作成。(インデックス名、テーブル名はダミー)データサイズに応じた処理時間がかかる。
CREATE INDEX index_hogehoge_on_text ON hogehoge USING pgroonga (text);
全文検索機能が正しく機能することを確認して、作業終了。
Amazon OpenSearch Service 設定変更時の Blue/Green デプロイについて
TL;DR
- Amazon OpenSearch Service では、ドメインの合計ノード数が1の場合でも、ほぼ無停止で設定の変更ができる。
- 設定変更が完了するまでは、旧設定のままでドメインが稼働する。
- ノード数が1の場合停止時間が発生する Elastic Cloud とは挙動が異なるため、OpenSearch Serviceに慣れていないと「ノードが止まってない=設定は即時反映されたのか?」と誤解する可能性がある
どういうことか
OpenSearch Service では、ドメインの更新時に Blue/Green デプロイプロセスが使用されます。Blue/Green は通常、2 つの本稼働環境 (ライブとアイドル) に使用して、ソフトウェアの変更時に両者間で切り替える方法を指します。OpenSearch Service の場合は、ドメインの更新用に新しい環境を作成し、これらの更新の完了後に新しい環境にユーザーをルーティングする方法を指します。この方法では、新しい環境へのデプロイに失敗しても、ダウンタイムを最小限に抑えることができ、元の環境を維持することができます。
Blue/Green デプロイ
管理コンソール上で OpenSearch ドメインのセキュリティ設定を変更しようとすると、以下のようなメッセージが表示される。

暗号化設定を更新するために、Amazon OpenSearch Service はパフォーマンスに影響を与える可能性のある Blue/Green プロセスを使用します。
OpenSearch Service でドメインの設定変更を行う場合、
- 新しい設定を適用した新ノードを起動
- 新ノード起動後、ネットワークを旧ノードから新ノードへ切り替え
という手順を踏むことで、稼働状態を維持したまま設定が変更される。この挙動は「Blue/Greenデプロイ」と呼ばれる。
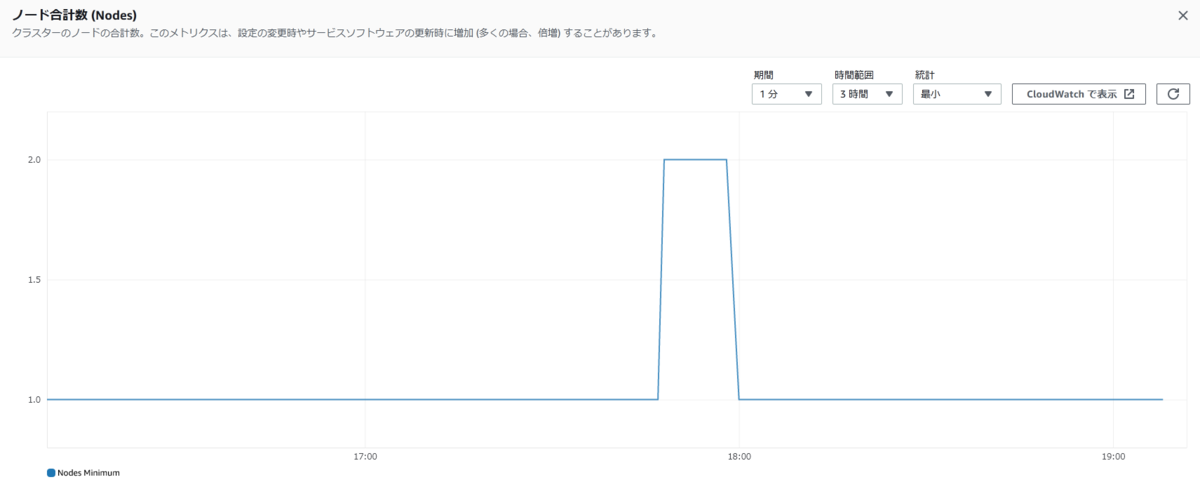
設定適用中は、一時的にノードの数が自動的に増加する。(多くの設定変更の場合、追加料金はかからないようだ)
これにより、OpenSearch Serivceでは設定の変更反映中でも、普通にドメインにアクセスすることができる。
変更反映中かどうかの表示がわかりづらい
ただし、注意しなければならない点があり、設定変更中かどうかの表示が微妙にわかりづらいのである。

ドメインの一覧表示。設定変更中の場合は、ステータス欄に「処理中」と表示される。

一方、設定変更が完了した通常時は「アクティブ」と表示される。
変更反映中は、古い設定内容が適用される
Blue/Green デプロイによる変更反映中は、前述の通り通常のアクセスが可能である。
ただし、変更反映中は旧設定が適用され、変更が完了したタイミングで即時新設定が適用される、というような動作になる。
…上記の挙動は当然といえば当然なのだが、「ドメインが停止し、再起動完了後は新設定になっている」でも「変更ボタンを押したタイミングで即時新設定となる」でもない点に注意。
設定が適用されたタイミングがわかりづらいかも?
OpenSearch Service では、たとえドメインに1ノードしか存在しない場合でも、設定変更によりドメイン全体が停止することはない。
この挙動は、2ノード以上の場合 ローリングで設定が適用される(=1ノードの場合はドメイン停止時間が発生する) Elastic Cloud とは異なるものである。
そのため、Elastic Cloudに慣れている人の場合、
- 「1ノードなのに設定変更でドメインが停止しない」
- →「設定は即時反映されている?」
...という錯覚に陥る可能性がある。(現に私はそうでした...)
また上述の通り、設定変更中から設定変更完了状態に移行したタイミングが若干分かりづらい。
そのため、特にセキュリティ設定を変更している場合は、あるタイミングで接続できたものが突然接続できなくなる(またはその逆)という不可解現象に悩まされる可能性もあり、1ノードでの検証・テスト運用などでは注意が必要。
以下所感
Blue/Green デプロイの挙動については、1ノードでも停止時間が発生しないため非常に便利なものだという認識だが、如何せんステータスの表示が少々分かりづらいという点に問題があるように思う。
Elastic Cloud だと、設定を変更した場合は、変更中である旨がデカデカと表示されて誤解がないようになっていた記憶があるので、Amazon もその辺の表示をもっと親切丁寧に改善してほしいなあ...と思った昨今。
UnicodeをRubyで扱うときに使用する操作いろいろ
ある文字のUnicodeコードポイントを知りたい、または逆にコードポイントから文字を調べたい....と思うことがよくあるので、irbで打ち込むいろいろな操作のメモ。
(以下の例では、Rubyの文字列リテラルのエンコーディングはUTF-8の前提。)
コードポイント → UTF-8文字
Integer#chrメソッドを使用。
> 0x3042.chr(Encoding::UTF_8)
# => "あ"
コードポイント配列 → UTF-8文字列
配列要素単位で Integer#chr、またはまとめて Array#pack。
>  [0x3042, 0x3044, 0x3046, 0x3048, 0x304A].map {|n| n.chr(Encoding::UTF_8)}.join
#=> "あいうえお"
または
>  [0x3042, 0x3044, 0x3046, 0x3048, 0x304A].pack('U*')
#=> "あいうえお"
UTF-8文字 → コードポイント
String#ord メソッドを使用。(返り値はArrayとなるが、String#codepointsでもよい)
> 'あ'.ord.to_s(16)
#=> "3042"
UTF-8文字列 → コードポイント配列
- 1文字ずつ区切って
String#ord String#codepointsで一気に配列化(またはString#each_codepoint)String#unpack
> 'あいうえお'.split('').map{|c| c.ord.to_s(16) }
#=> ["3042", "3044", "3046", "3048", "304a"]
または
> 'あいうえお'.codepoints.map{|n| n.to_s(16) }
#=> ["3042", "3044", "3046", "3048", "304a"]
または
> 'あいうえお'.unpack('U*').map{|n| n.to_s(16) }
#=> ["3042", "3044", "3046", "3048", "304a"]
Unicode正規化
String#unicode_normalizeメソッドを使用。
> '神㌍'.unicode_normalize(:nfkc)
#=> "神カロリー"
